

Microsoft visar upp deepfakes-AI
Kan generera videoklipp baserat på ett foto
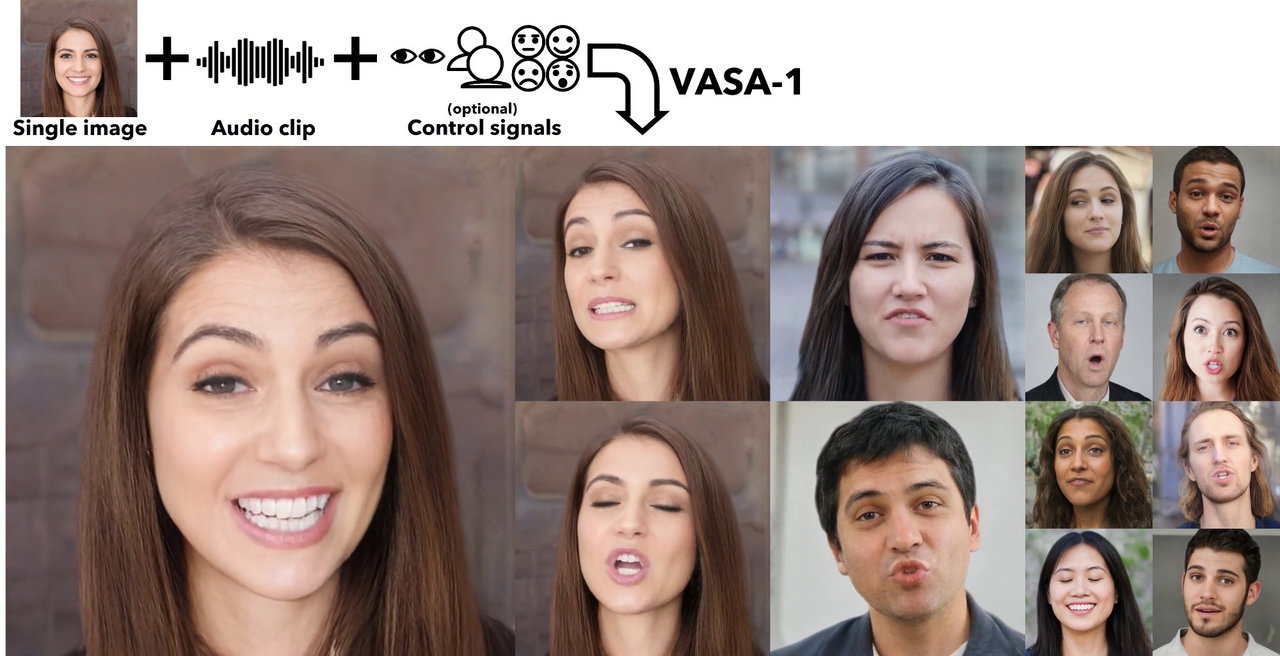
Microsoft Research Asia har visat upp en ny AI-modell som kan generera ganska realistiska videoklipp efter att AI:n matats med en bild och ett ljudspår.
Modellen kallas för Vasa-1 och kan matas med såväl autentiska porträttbilder såväl som foton på målningar eller andra ansiktsbilder. Här nedanför syns exempelvis en rappande Mona Lisa som Microsoft-forskarna genererat med hjälp av Vasa-1. Videos som genereras av Vasa-1 har för tillfället en upplösning på 512x512 pixlar och spelas upp i en hastighet av 40fps. Forskarna bakom Vasa-1 anser själva att deras nya modell ger ett bättre resultat än tidigare modeller som genererar videoklipp baserat på ett enda foto. De skriver:
"The core innovations include a holistic facial dynamics and head movement generation model that works in a face latent space, and the development of such an expressive and disentangled face latent space using videos. Through extensive experiments including evaluation on a set of new metrics, we show that our method significantly outperforms previous methods along various dimensions comprehensively."
Vasa-1 är i dagsläget ett forskningsprojekt. Om Microsoft har planer på att släppa AI-modellen publikt finns det än så länge inga uppgifter om. Hoppas ni vidare till projektets webbplats på länken nedan kan ni kolla in ett dussintal andra exempel där Vasa-1 använts för att generera deepfakes-klipp.
Läs gärna våra regler!