

Nvidia släpper öppna AI-modeller för översättning
Med inriktning på europeiska språk
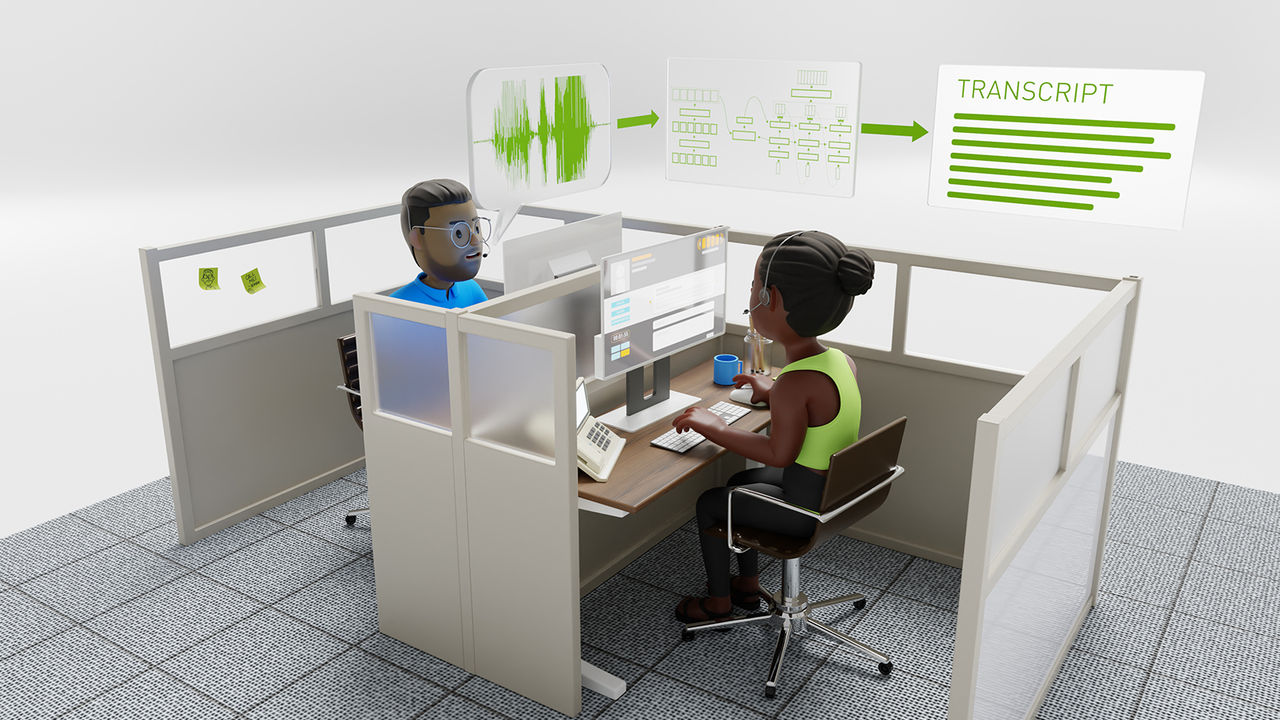
Nvidia har nu släppt ett flerspråkigt dataset med tal samt två AI-modeller som använder datan för att genomföra översättningar och transkriberingar på europeiska språk.
Datasetet "Granary" inkluderar 650.000 timmar för taligenkänning och 350.000 timmar för översättningar. AI-modellen "NVIDIA Canary-1b-v2" använder sig av datan för att transkribera och översätta mellan nästan samtliga av EU:s 24 officiella språk samt ryska och ukrainska. Den kan hantera en miljard parametrar och toppar för tillfället AI-tjänsten Hugging Face topplista över noggrannhet för öppna AI-modeller som används för flerspråkig taligenkänning.
Nvidia släpper även den lite mindre AI-modellen "NVIDIA Parakeet-tdt-0.6b-v3" som kan hantera 600 miljoner parametrar och är främst designad för realtidsöversättningar och stora volymer av översättningar.
Vill ni testa Nvidias nya dataset och AI-modeller så går dessa att ladda hem från GitHub och vidare instruktioner för hur de används hittas på Hugging Face.
Läs gärna våra regler!