Gräset väntar till våren, men valet av robotgräsklippare kan göras redan nu. Om du planerar att köpa en klippare inför nästa säsong kan ett kampanjpris vara ett bra tillfälle, samtidigt som du är redo när gräset börjar växa i vår.
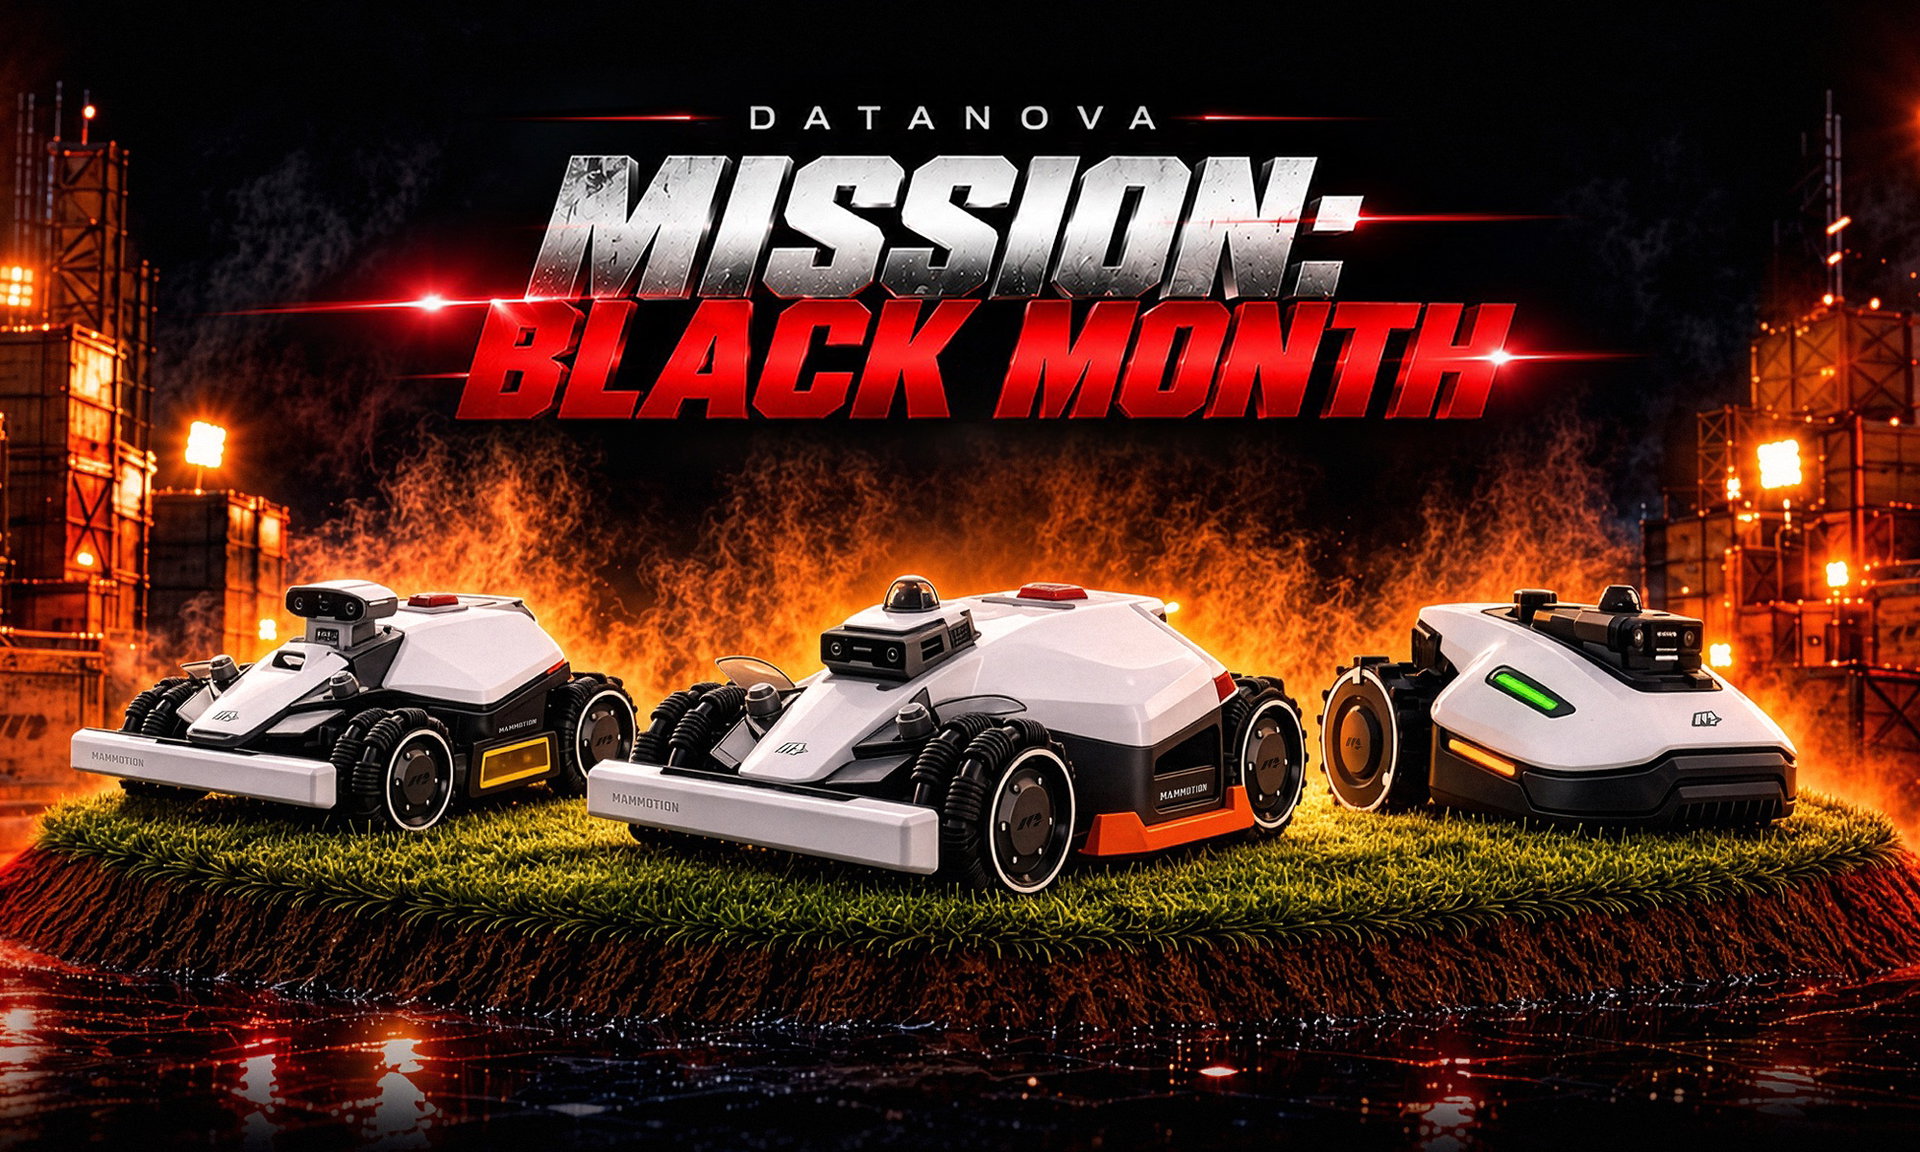
DataNova kör nämligen Mission: Black Month och sänker priserna på Mammotions robotgräsklippare till årets lägsta, med upp till 8 000 kronor i rabatt. Jämför i lugn och ro bland årets testvinnande robotgräsklippare och välj utifrån gräsytans storlek och hur kuperad tomten är.
Ingen slinga att gräva ner, varken nu eller sen
Alla tre modeller klarar sig utan begränsningskabel. Du ritar upp gräsmattan, klippzonerna och områdena klipparen ska hålla sig borta från direkt i appen. Glöm spaden, och glöm att leta kabelbrott efter ett vinterhalvår med tjäle.LUBA 3 AWD 3000 – för stora tomter och branta backar
Har du mycket mark att ta hand om är det här maskinen. LUBA 3 AWD klarar hela 3 000 kvadratmeter och kombinerar LiDAR, satellitpositionering och dubbla AI-kameror för att veta exakt var den är, även under träd och nära husväggen. Med fyrhjulsdrift tar den sig uppför lutningar på upp till 80 procent. Där vanliga robotklippare ger upp och snurrar på stället kör LUBA 3 bara vidare.Två klippskivor ger 40 centimeters klippbredd och upp till 650 kvadratmeter i timmen, och den väjer för över 300 olika typer av hinder. Just nu får du dessutom ett serviceställ på köpet.
LUBA mini 2 AWD 1000 – fyrhjulsdrift för den vanliga villatomten
Tycker du att LUBA 3 låter grym men har en tomt i mer normal storlek? Då är LUBA mini 2 AWD svaret. Den passar de allra flesta villaägare med tomter på upp till 1 000 kvadratmeter, och har samma fyrhjulsdrift och förmåga att klättra i 80 procents lutning som storebror.Tre AI-kameror och satellitpositionering håller koll på var gräsmattan börjar och slutar, och kantklippningen gör att du slipper gå runt med trimmern efteråt. Serviceställ ingår även här.
YUKA Mini 2 800 – liten och smidig, med garage på köpet!
Har du en mindre och mer okomplicerad trädgård räcker YUKA Mini 2 långt. Den klarar 800 kvadratmeter, hittar rätt med 360-graders LiDAR och dubbla AI-kameror och väjer för leksaker, krukor och trädgårdsslangar.Och det bästa? Ett garage ingår utan extra kostnad, så klipparen slipper stå och dra på sig regn och löv.
Psst... Black Month-kampanjen pågår till och med 30 november, eller så långt lagret räcker. Handla tryggt hos DataNova som är Mammotions officiella generalagent i Sverige.
DataNova erbjuder svensk support och lokal service på alla Mammotions robotgräsklippare, vilket är en stor fördel om du vill få snabb hjälp med installation, reparation eller reservdelar.
Feber | Sponsrade artiklar, Annons, Mammotion, DataNova, robotgräsklippare, Black Month, Black Friday, trädgård




Läs gärna våra regler!