
Harvard släpper datadump med en miljon böcker
AI-företagens nya guldgruva?
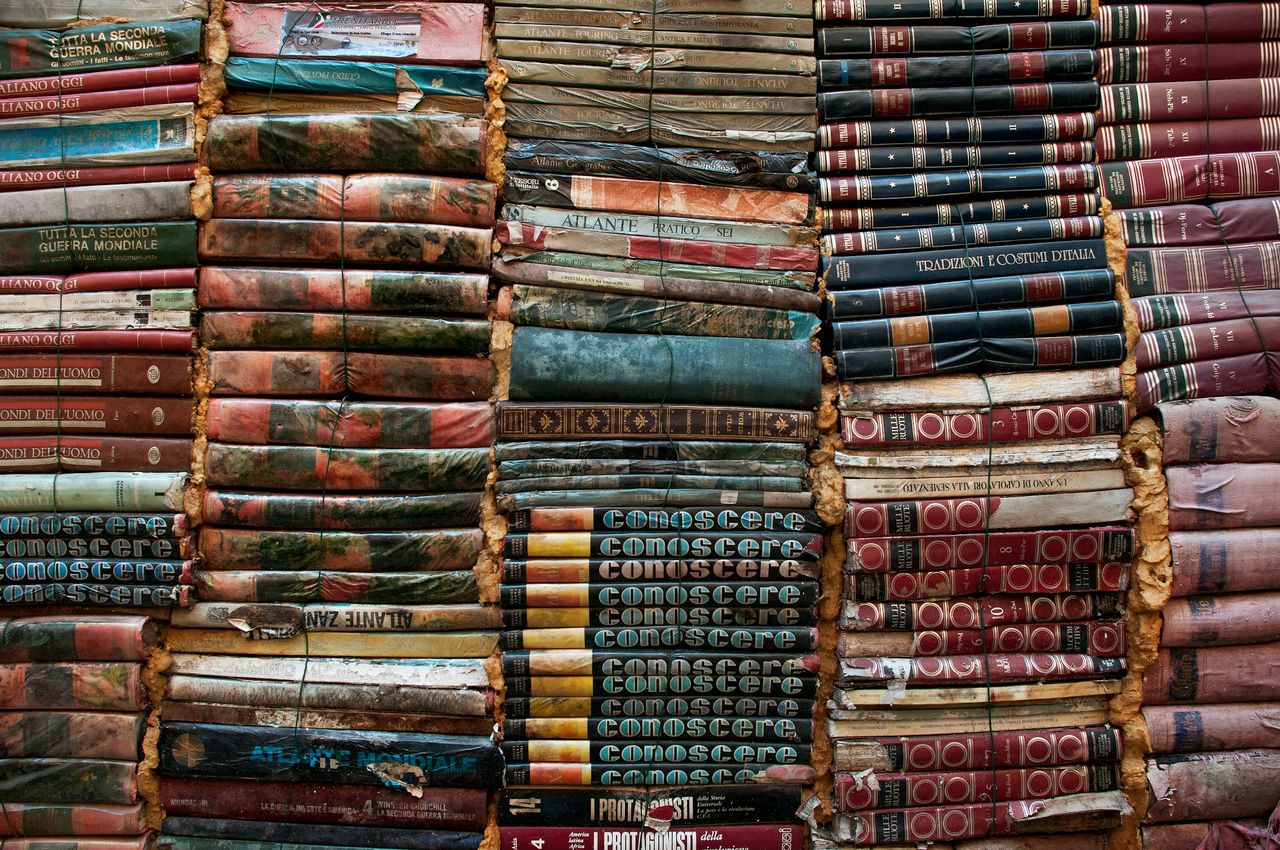
Om man ska erbjuda en vettig AI-modell så måste den lära sig vettiga saker, vilket som bekant inte alltid sker via helt kosher metoder. Men ett sätt som AI-modellerna nu kan bli lite smartare på, utan att passera några gråzoner, är via en ny enorm datadump från Harvard University. De har nämligen samlat nästan en miljon böcker som är tillräckligt gamla för att deras upphovsrättsskydd har upphört.
Projektet, som är en del av den nya Institutional Data Initiative, har fått finansiering från Microsoft och OpenAI. Böckerna, som har skannats av Google Books, innehåller en bred variation av verk, från klassiker som Shakespeare och Charles Dickens till mer obskyra tjeckiska matematikläroböcker. För AI-modeller som ChatGPT, som eftersträvar att efterlikna mänskligt beteende, är stora mängder högkvalitativ text avgörande för deras utveckling.
Trots att Harvards datadump med en miljon böcker inte räcker för att tillgodose alla AI-företags behov, erbjuder den en laglig väg för att träna grundläggande modeller. Så i takt med att AI-företag fortsätter att söka efter exklusivt innehåll för att särskilja sig från konkurrenterna, kan detta dataset ändå vara en värdefull resurs.
Läs gärna våra regler!