

Google presenterar TurboQuant
Ny teknik som effektiviserar AI-modellers minneshantering
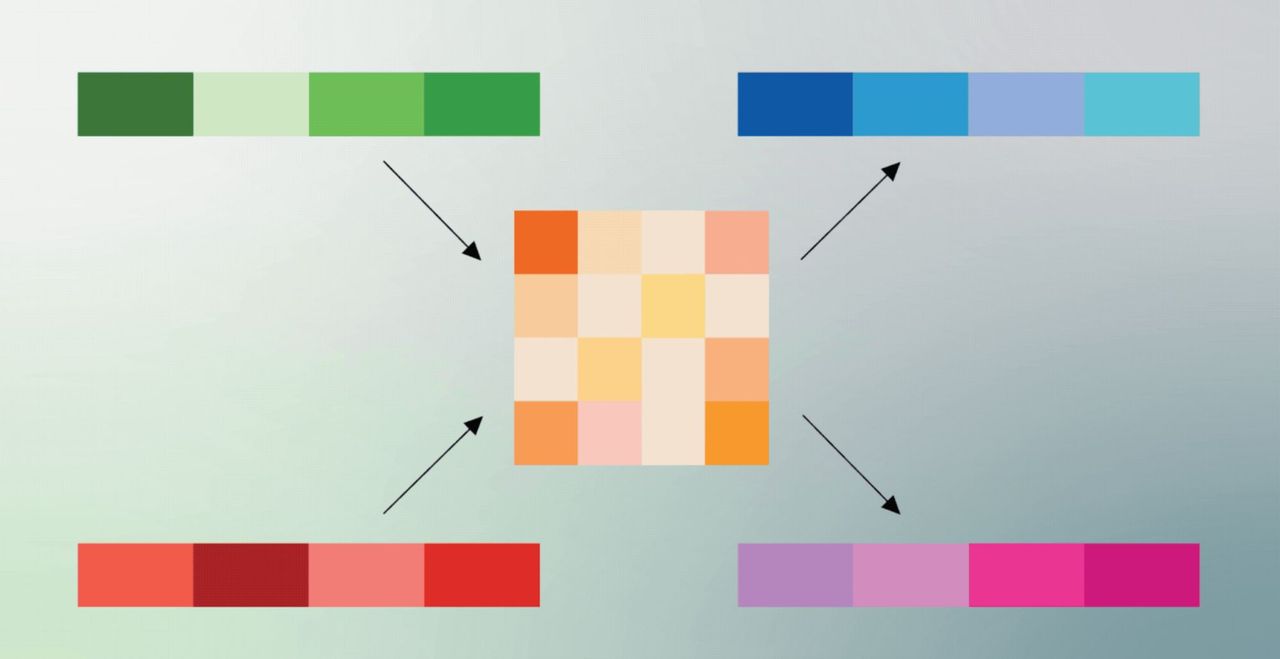
Google Research har utvecklat en komprimeringsteknik som kanske kan leda till att AI-modeller går att hantera med mindre minnesmängder än vad som krävs idag.
Google kallar det hela för TurboQuant och det går i korthet ut på att de stora mängder data som AI-modellerna hanterar i ett cacheminne kan komprimeras 6-8 gånger sin ursprungsstorlek, något som i sin tur leder till att det krävs mindre minne för AI-modellens beräkningar. Google skriver:
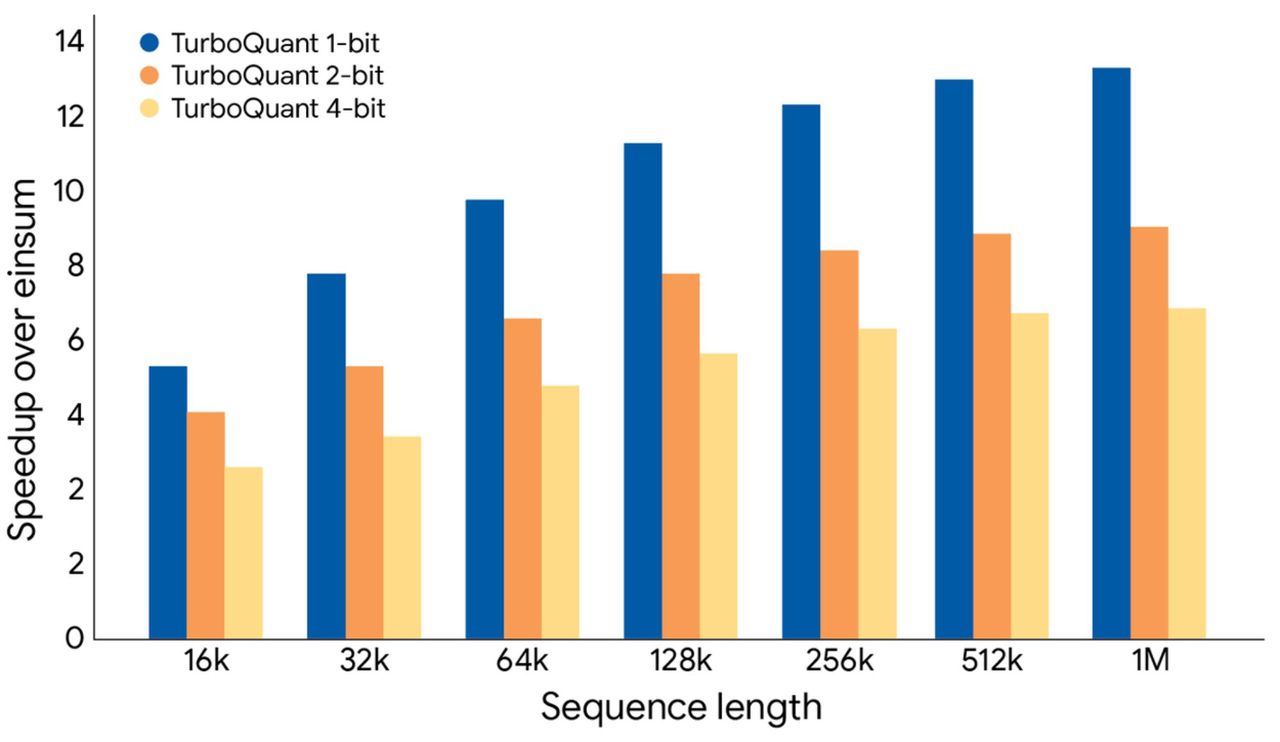
"TurboQuant proved it can quantize the key-value cache to just 3 bits without requiring training or fine-tuning and causing any compromise in model accuracy, all while achieving a faster runtime than the original LLMs (Gemma and Mistral). It is exceptionally efficient to implement and incurs negligible runtime overhead. The following plot illustrates the speedup in computing attention logits using TurboQuant: specifically, 4-bit TurboQuant achieves up to 8x performance increase over 32-bit unquantized keys on H100 GPU accelerators."
TurboQuant kan med andra ord göra det möjligt för framtidens AI att hantera mycket längre sammanhang snabbare och på billigare hårdvara än vad som tidigare varit teoretiskt möjligt. Det kan även göra det möjligt att köra mer avancerade AI-modeller lokalt, till exempel på mobiltelefoner, och att AI-hanteringen inte blir lika beroende av molnberäkningar.
Läs gärna våra regler!